Desde 28 de outubro de 2026, o GitHub Copilot oferece o Copilot Fusion para todos os planos. A pessoa deixa de escolher manualmente um modelo de IA para cada tarefa. Ela seleciona o Fusion e um nível de esforço, e o Copilot decide quais modelos usar e como combiná-los (changelog do GitHub).
Por que importa
Quem programa com IA hoje precisa decidir, a cada tarefa, entre modelos mais baratos e modelos mais fortes. O Fusion transfere essa decisão para o próprio Copilot. Na prática, a escolha deixa de ser "qual modelo?" e passa a ser "quanto esforço esta tarefa merece?". Isso afeta custo, tempo de espera e a forma como as equipes controlam o uso de IA.
O que mudou
O Fusion junta duas coisas. A primeira é a orquestração de vários modelos do Project HydraFusion, que estreou como prévia de pesquisa no Copilot CLI em 4 de setembro. A segunda é a seleção automática de modelo que o Copilot já oferecia (DEV Community).
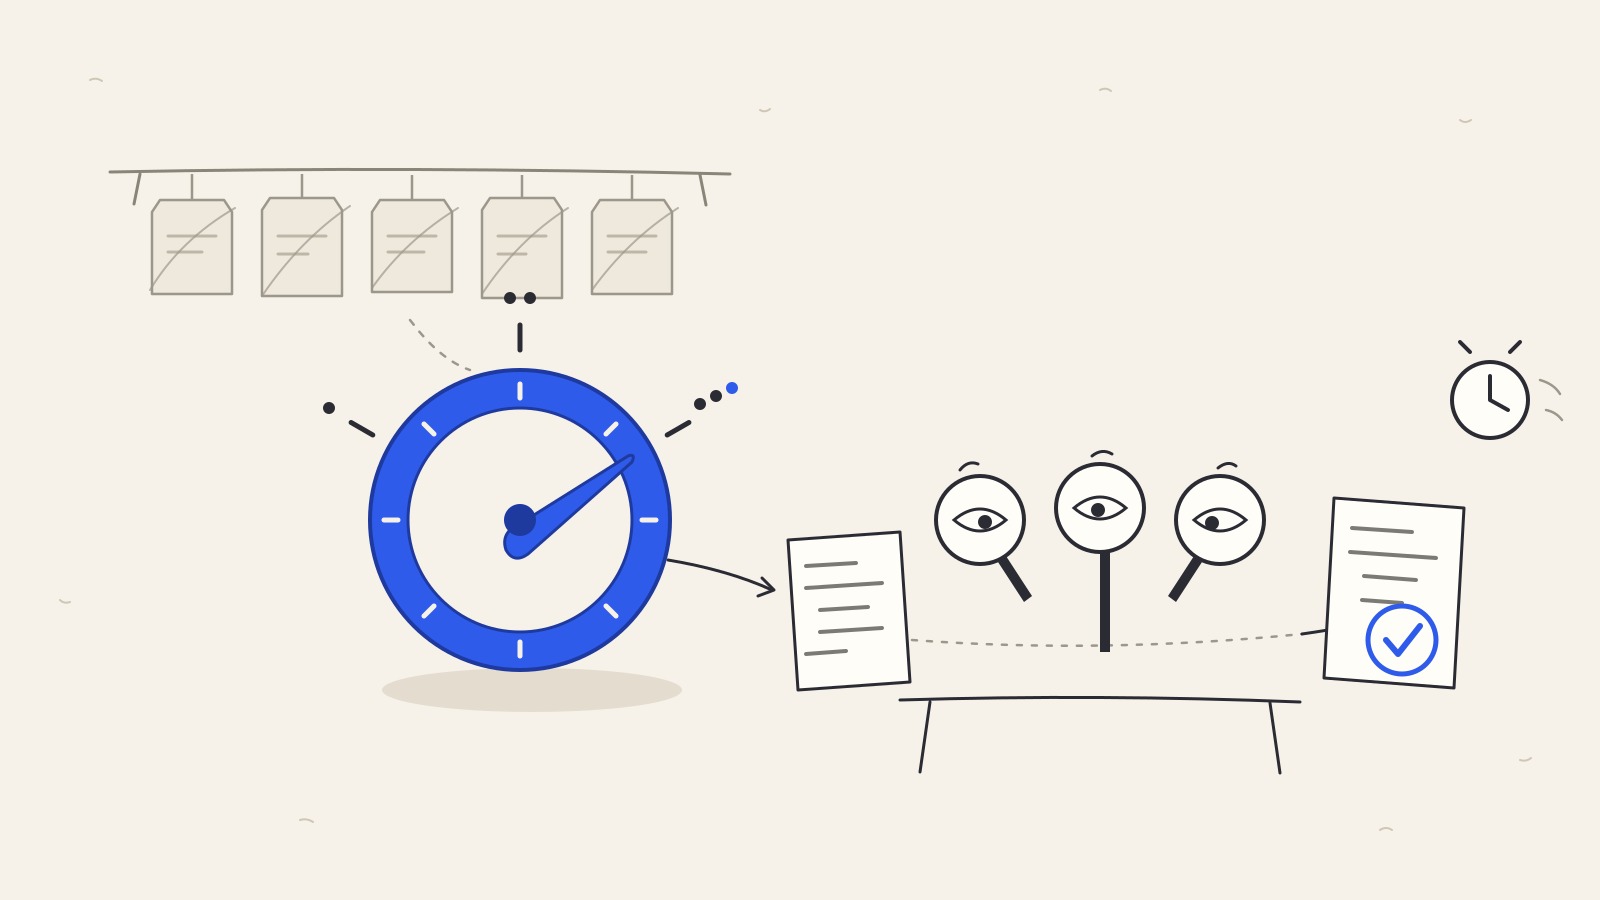
No seletor de modelos, basta escolher Copilot Fusion e um dos três níveis. Standard serve para o dia a dia. High é para tarefas difíceis, com raciocínio mais profundo. Max fica para as tarefas mais exigentes. Por trás, a documentação descreve dois padrões de execução:
- Cascade: um modelo econômico escreve um rascunho. Uma verificação de qualidade decide se o aceita ou se repassa a tarefa a um modelo mais forte.
- Critique: um modelo escreve o rascunho enquanto vários outros o criticam em paralelo.
O recurso funciona no VS Code, no Copilot CLI, no app Copilot e nas IDEs JetBrains. A cobrança é feita por modelo usado na tarefa. Até 30 de novembro de 2026, há 30% de desconto sobre o custo dos modelos acionados pelo Fusion (changelog).
Em empresas, o Fusion só usa os modelos liberados pelas políticas da empresa e da organização. Administradores podem ver entre quais modelos ele escolhe e desligar um modelo apenas para o Fusion. Modelos instalados localmente também podem entrar na combinação, mas só no nível Standard. Uma fonte secundária descreve esse recurso como prévia experimental (Neowin).
Desempenho: uma medição externa, paga pelo GitHub
A Artificial Analysis avaliou apenas o nível Max, no Copilot CLI, pelo Coding Agent Index. O Fusion Max fez 60 pontos, contra 62 do Claude Code com Opus 5.5 no esforço máximo. O custo foi de US$ 5,59 por tarefa, contra US$ 11,42 (Artificial Analysis). Ele ficou levemente à frente no Terminal-Bench 4.0, com 71 pontos, e em terceiro no FrontierCode, com 51 (detalhes).
O próprio GitHub declarou que encomendou e financiou essa avaliação. Por isso, ela não é independente. Segundo a VentureBeat, os "40% menos tempo" continuam sendo um número do GitHub. Já a economia de até 77% citada por Satya Nadella vem de uma avaliação interna da empresa.
Como usar
Sugestão de teste (não realizado por nós):
- Separe de 10 a 20 tarefas reais do seu projeto.
- Rode cada uma no Standard, no High e no Max.
- Compare os créditos gastos, o tempo de espera, o tempo de revisão e o retrabalho.
- Trabalhe numa branch separada e revise o diff completo antes de aceitar qualquer mudança.
Assim você descobre qual nível compensa no seu caso, sem depender dos números do anúncio.
O que observar
- Mais espera. Cascade e Critique demoram mais, porque incluem chamadas extras de revisão.
- Pouca evidência sobre Standard e High. Não há medições externas desses níveis.
- Pouco controle sobre a combinação. Na fase HydraFusion, não era possível escolher os modelos usados, e a combinação mudava sem lista fixa. Não confirmamos se isso continua igual no Fusion.
- Acesso por plano. Não conseguimos confirmar se os planos Free e Student têm acesso ao High e ao Max.
- Revisão continua necessária. O lançamento não dispensa políticas de modelos, permissões mínimas para agentes, testes e revisão humana do código.